

Cuando un generador de imágenes crea un retrato, una ilustración o una escena fantástica, una de las preguntas más discutidas es de dónde salió realmente esa imagen. ¿Puede vincularse con una obra concreta del conjunto de entrenamiento? ¿Se parece a un artista específico porque lo copió o porque aprendió patrones más generales? Un estudio de MIT sugiere que, en muchos casos, esa búsqueda puede no tener una respuesta clara.
El trabajo, publicado en Nature Communications, analizó modelos de difusión, la familia de sistemas que hoy domina la generación automática de imágenes. Los investigadores encontraron que, a medida que estos modelos se entrenan con conjuntos de datos más grandes, el peso de cada ejemplo individual se diluye hasta hacerse muy difícil de detectar. El equipo llamó a este fenómeno “decadencia de atribución”.
La idea central es simple, aunque probarla no lo sea. Si se quita una imagen del entrenamiento y la salida del modelo no cambia, entonces esa imagen no parece haber influido de forma decisiva en el resultado. Según los autores, eso también vale si se elimina toda la obra de un artista o todas las fotos de una persona y la imagen generada sigue siendo prácticamente la misma.
Para poner a prueba esa idea, el equipo diseñó una arquitectura llamada “diffusion ensemble”. En lugar de entrenar un único modelo grande, dividieron el aprendizaje en múltiples componentes más pequeños, cada uno expuesto a una parte distinta de los datos. Eso les permitió apagar selectivamente las partes que habían visto cierto material y observar qué cambiaba sin tener que reentrenar el sistema desde cero cada vez.
Los investigadores compararon 24 de estos conjuntos con modelos de difusión convencionales entrenados sobre los mismos datos. Después probaron qué pasaba cuando eliminaban ejemplos del entrenamiento en colecciones que iban desde 256 imágenes hasta más de 160.000. El patrón fue consistente: cuanto mayor era la base de datos, menor era el efecto detectable de quitar una imagen concreta. En otras palabras, la salida parecía depender cada vez menos de una fuente individual y más de una mezcla estadística mucho más distribuida.
Eso no significa que los modelos sean mágicamente independientes de sus datos. Siguen aprendiendo de ellos y sin ese material no existirían. Lo que cambia, según el estudio, es la posibilidad de señalar una imagen específica y decir: “esta salida viene de aquí”. Para los autores, en modelos grandes ese vínculo puede disolverse hasta volverse inapreciable.
El resultado importa porque toca un debate que ya salió de los laboratorios. Empresas tecnológicas, artistas, jueces y legisladores discuten si las imágenes generadas por IA deben tratarse como obras derivadas de material protegido por derechos de autor. Este estudio no resuelve por sí solo esa discusión, pero sí complica la idea de que siempre pueda encontrarse una línea directa entre una salida y una obra individual del entrenamiento.
También hay una consecuencia científica y técnica. Si el hallazgo se sostiene en otros contextos, puede cambiar cómo se investiga la influencia de los datos en sistemas generativos y cómo se diseñan herramientas para auditar modelos. El artículo plantea, además, que entender esta pérdida de rastro podría ayudar a construir sistemas en los que sea más claro cuándo una semejanza se debe a copia y cuándo surge de combinaciones más generales aprendidas por el modelo.
El estudio, sin embargo, tiene límites importantes. Se centró en generadores de imágenes basados en difusión, no en modelos de lenguaje como los que están en el centro de muchos conflictos actuales sobre texto e IA. Además, la “decadencia de atribución” no implica que desaparezcan todos los problemas de propiedad intelectual, sesgo o uso indebido de datos. Solo muestra que, en ciertos modelos y a determinada escala, rastrear una salida hasta un ejemplo concreto puede dejar de ser una estrategia útil.
Esa distinción es importante. La investigación no dice que entrenar con obras ajenas sea irrelevante ni que la discusión legal esté cerrada. Lo que muestra es algo más incómodo: puede llegar un punto en que el modelo siga dependiendo del conjunto completo de datos, pero ya no de una pieza individual de manera demostrable. Para un debate público que suele buscar responsables claros y cadenas de influencia precisas, ese resultado vuelve el problema mucho más difícil de encajar.
When AI art has no author: Study finds generated images often can’t be traced to training data · MIT News Research
Ciencias.uy / MiniMax image-01 · Imagen generada con MiniMax image-01 para Ciencias.uy; uso editorial no comercial; CC BY 4.0 · Fuente de imagen
Dai, Z., & Gifford, D. K. (2026). Outputs of generative diffusion models are often unattributable. Nature Communications, 17, 6974. https://doi.org/10.1038/s41467-026-75667-5
Relacionadas por categoría
Ver mas
Un método adaptativo mejora la detección de texto generado por IA en pruebas controladas
Un preprint probó un detector que se ajusta a textos recientes sin etiquetas y rindió mejor ante cambios de estilo y tácticas para eludirlo.
Una IA intenta simular arena, agua y proteínas con un mismo modelo
Un preprint presenta WorldParticle, un modelo que representa distintos materiales como partículas para predecir su movimiento. Sus pruebas son prometedoras, pero no reemplazan todavía a los simuladores especializados.
Un sistema convierte artículos científicos en asistentes reutilizables
Un método empaqueta texto, código, datos y flujos de trabajo de algunos estudios para que una IA pueda ejecutar análisis y responder consultas en lenguaje natural.
Más de la misma fuente
Ver mas
Un material seco podría extender el uso de ecografías portátiles sin gel
Una interfaz elástica y seca transmitió ultrasonido durante días en pruebas de laboratorio y siguió el flujo sanguíneo durante un paseo en bicicleta.
Los centros de datos pueden desplazar la contaminación del aire a otras regiones
Un modelo sobre Estados Unidos estima que la electricidad adicional de los centros de datos puede elevar la contaminación del aire lejos de sus instalaciones.
Un método adaptativo mejora la detección de texto generado por IA en pruebas controladas
Un preprint probó un detector que se ajusta a textos recientes sin etiquetas y rindió mejor ante cambios de estilo y tácticas para eludirlo.
Más del mismo autor
Ver mas
El clima puede cambiar el mapa de plagas en bosques de Norteamérica
Un estudio proyecta que, si las emisiones siguen altas, más del 80% de los bosques analizados en Norteamérica podría enfrentar mayor presión de plagas y enfermedades hacia mediados de siglo.
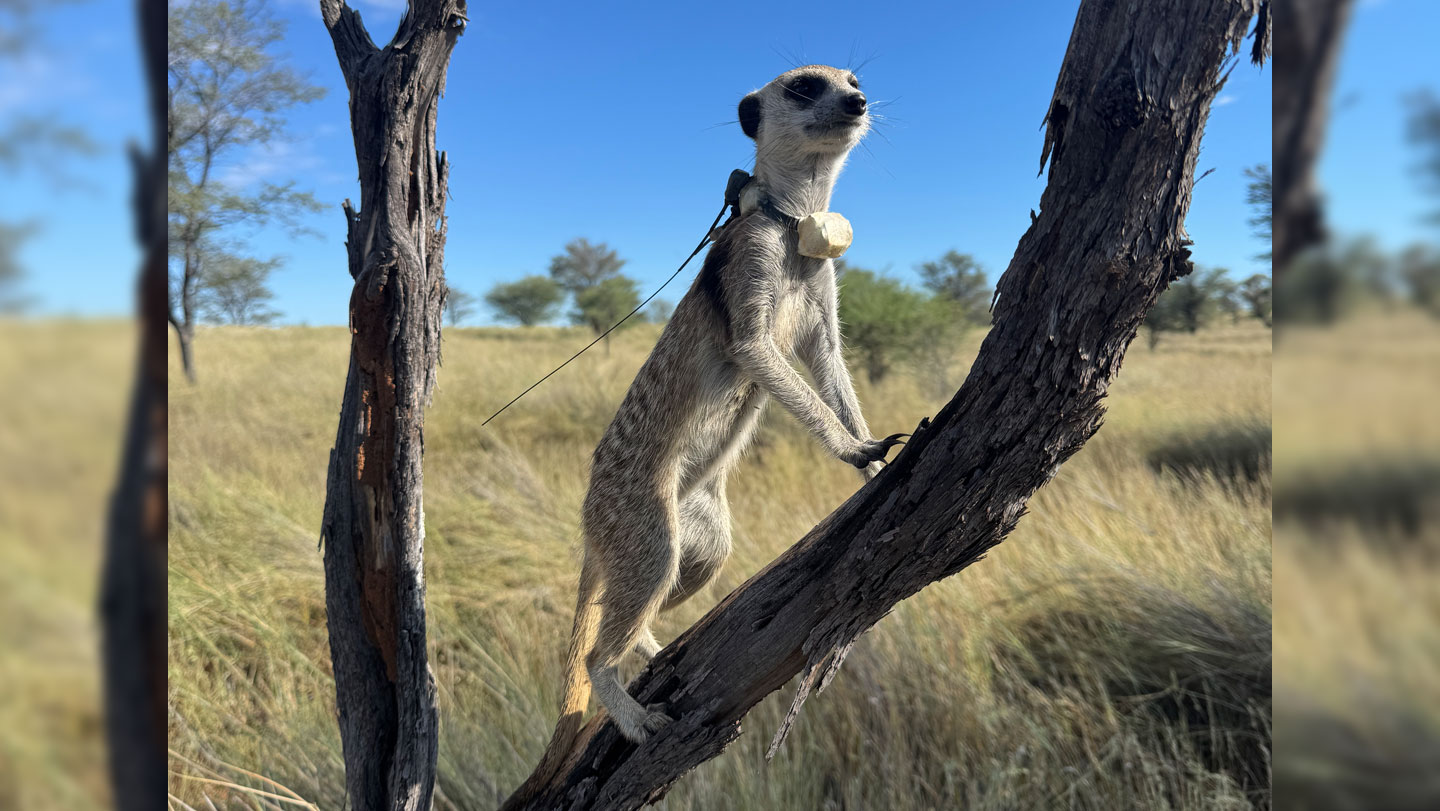
Las suricatas pueden volver solas a su grupo tras ser desplazadas
Un experimento de campo halló que 18 de 20 suricatas desplazadas a 1,5 kilómetros regresaron de forma dirigida, sin seguir a otros miembros de su grupo.
Un material seco podría extender el uso de ecografías portátiles sin gel
Una interfaz elástica y seca transmitió ultrasonido durante días en pruebas de laboratorio y siguió el flujo sanguíneo durante un paseo en bicicleta.