

Los programas que intentan distinguir entre un texto humano y uno generado por inteligencia artificial tienen un problema de base: aprenden de una fotografía del pasado, mientras que la escritura y los modelos cambian. Un equipo de MIT y Cornell propone que esos detectores puedan ajustarse durante su uso a ejemplos recientes, aún cuando nadie les indique de antemano cuáles fueron escritos por una persona y cuáles por una máquina.
La idea no busca convertir un detector en un juez definitivo de autoría. Más bien, aborda una fragilidad concreta: un sistema entrenado con textos de hace años puede confundirse con estilos nuevos, con modelos lingüísticos recién lanzados o con textos que fueron retocados deliberadamente para parecer humanos. Esas variaciones hacen que las señales estadísticas que el detector aprendió dejen de ser fiables.
El trabajo, presentado como preprint en arXiv, ensayó una técnica llamada adaptación durante la prueba. En vez de dejar el programa inmóvil después de entrenarlo, los investigadores le permiten ajustar parte de sus parámetros al recibir un conjunto de textos recientes sin etiquetas. El supuesto es que, aunque el sistema no sepa quién escribió cada ejemplo, ese conjunto refleja mejor las condiciones en las que debe funcionar que los datos antiguos con los que fue construido.
Para poner a prueba la propuesta, el equipo reunió conjuntos con escritura humana y generada por modelos de lenguaje, y ocultó las etiquetas al detector durante la adaptación. También creó ejemplos de texto generado por IA que habían sido modificados para intentar evadir los controles. Después comparó el desempeño del método adaptativo con detectores que permanecen fijos. En una prueba diseñada para imitar cambios graduales en el uso del lenguaje, el sistema adaptativo alcanzó 85 % de aciertos, frente a 73 % de los métodos tradicionales.
La diferencia fue mayor en el escenario de evasión construido por los autores. Allí, un detector comercial identificó 27,0 % de los textos de IA disfrazados, mientras que el enfoque adaptativo llegó a 93,3 %. Esa cifra no significa que cualquier herramienta pueda reconocer con esa precisión un texto aislado en una clase, una redacción o un proceso de selección laboral. Describe el resultado dentro de los datos, las herramientas y las estrategias de evasión elegidas para el experimento.
El estudio ayuda a entender por qué los detectores de IA pueden dar resultados contradictorios. No buscan una marca infalible de autoría: estiman patrones que dependen de los textos con los que fueron entrenados y de los que encuentran después. Si los patrones cambian, un veredicto automático puede cometer tanto falsos positivos —señalar como artificial un texto humano— como falsos negativos.
La adaptación también abre interrogantes. Si el detector aprende de material reciente sin conocer su origen, necesita suficientes ejemplos y puede incorporar señales sesgadas o contaminadas. Los propios autores advierten que el problema podría volverse más difícil a medida que los modelos generen textos menos distinguibles de los humanos y sea más complicado reunir escritura humana verificable para entrenar o evaluar los sistemas.
Por ahora, se trata de un preprint, es decir, de un trabajo que aún no cuenta con la evaluación formal de una revista científica. Sus resultados son una prueba de concepto sobre cómo probar detectores frente a un entorno que cambia, no una garantía para decidir por sí sola la autoría de un texto. Esa distinción es especialmente importante allí donde una clasificación errónea puede afectar a estudiantes, autores o trabajadores.
Helping AI text detectors keep up with changing conditions · MIT News Research
Jose-Luis Olivares, MIT; Getty Images · CC BY-NC-ND; imagen acompañante del artículo fuente · Fuente de imagen
Ren, K., Raghavan, M., & Garg, N. (2026). Hitting a Moving Target: Test-Time Adaptation for AI Text Detection under Continual Distribution Shift [Preprint]. arXiv. https://doi.org/10.48550/arXiv.2606.25152
Relacionadas por categoría
Ver mas
Una IA intenta simular arena, agua y proteínas con un mismo modelo
Un preprint presenta WorldParticle, un modelo que representa distintos materiales como partículas para predecir su movimiento. Sus pruebas son prometedoras, pero no reemplazan todavía a los simuladores especializados.
Un sistema convierte artículos científicos en asistentes reutilizables
Un método empaqueta texto, código, datos y flujos de trabajo de algunos estudios para que una IA pueda ejecutar análisis y responder consultas en lenguaje natural.
Un cúbit lógico redujo sus errores a unos pocos por millón de ciclos
Un experimento con iones atrapados mostró que aumentar la protección de un cúbit lógico redujo de forma marcada sus errores. El resultado es prometedor, pero todavía es un preprint y una demostración de pequeña escala.
Más de la misma fuente
Ver mas
Un material seco podría extender el uso de ecografías portátiles sin gel
Una interfaz elástica y seca transmitió ultrasonido durante días en pruebas de laboratorio y siguió el flujo sanguíneo durante un paseo en bicicleta.
Los centros de datos pueden desplazar la contaminación del aire a otras regiones
Un modelo sobre Estados Unidos estima que la electricidad adicional de los centros de datos puede elevar la contaminación del aire lejos de sus instalaciones.
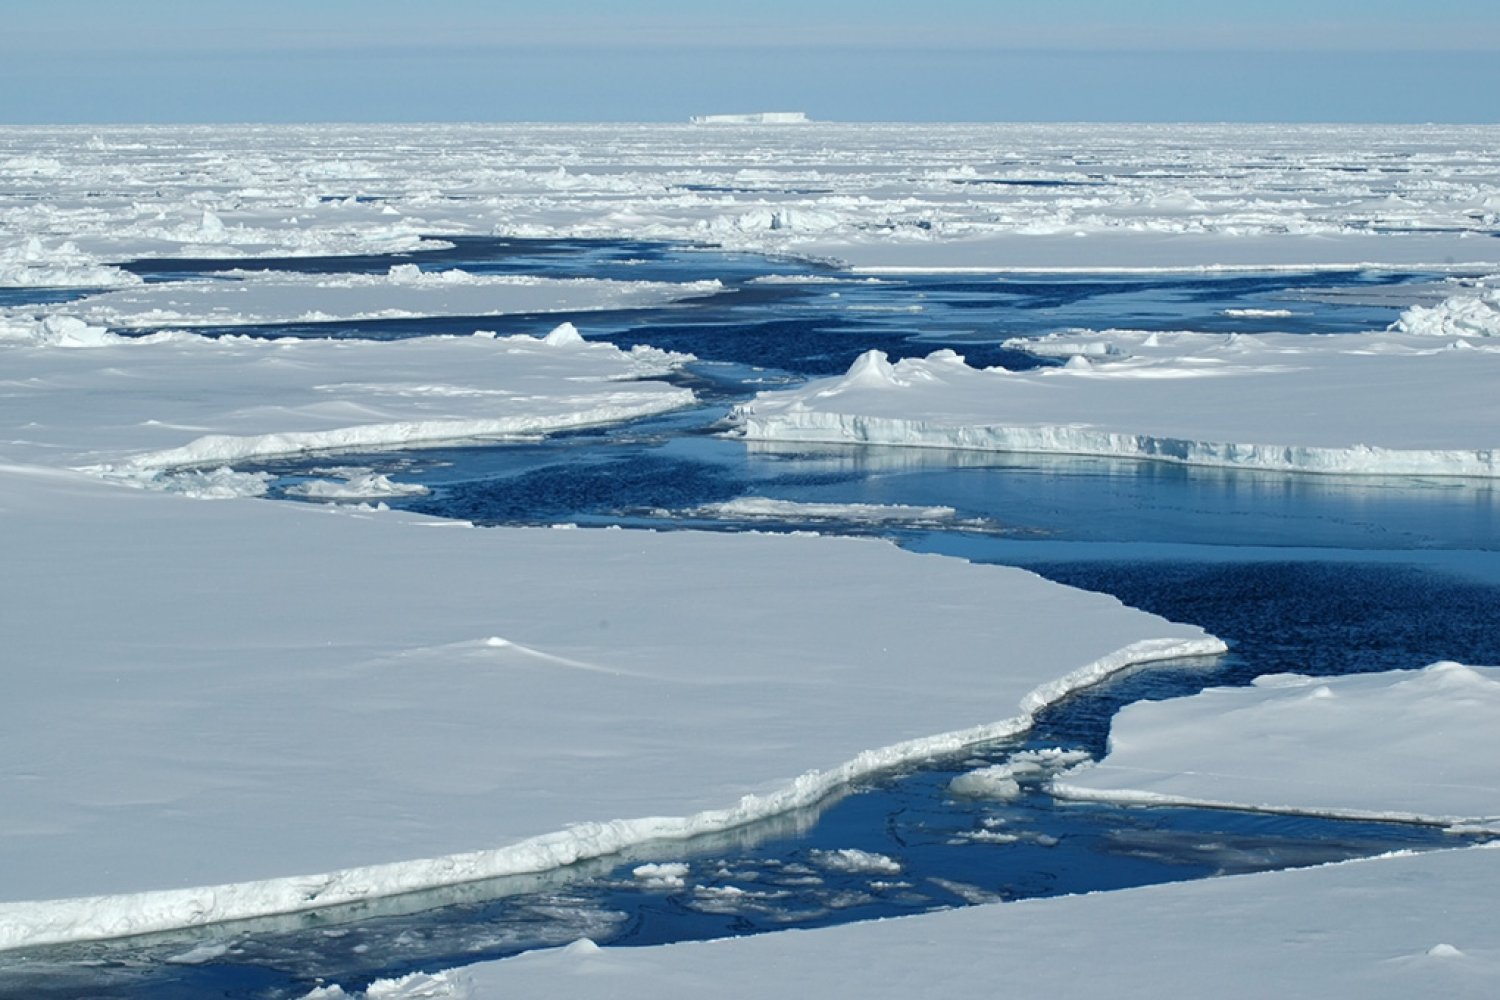
El hielo y las corrientes oceánicas actuaron juntos para guardar más carbono durante las glaciaciones
Un modelo climático muestra que el hielo marino antártico y la circulación oceánica se reforzaron mutuamente para retener carbono en las profundidades durante las glaciaciones.
Más del mismo autor
Ver mas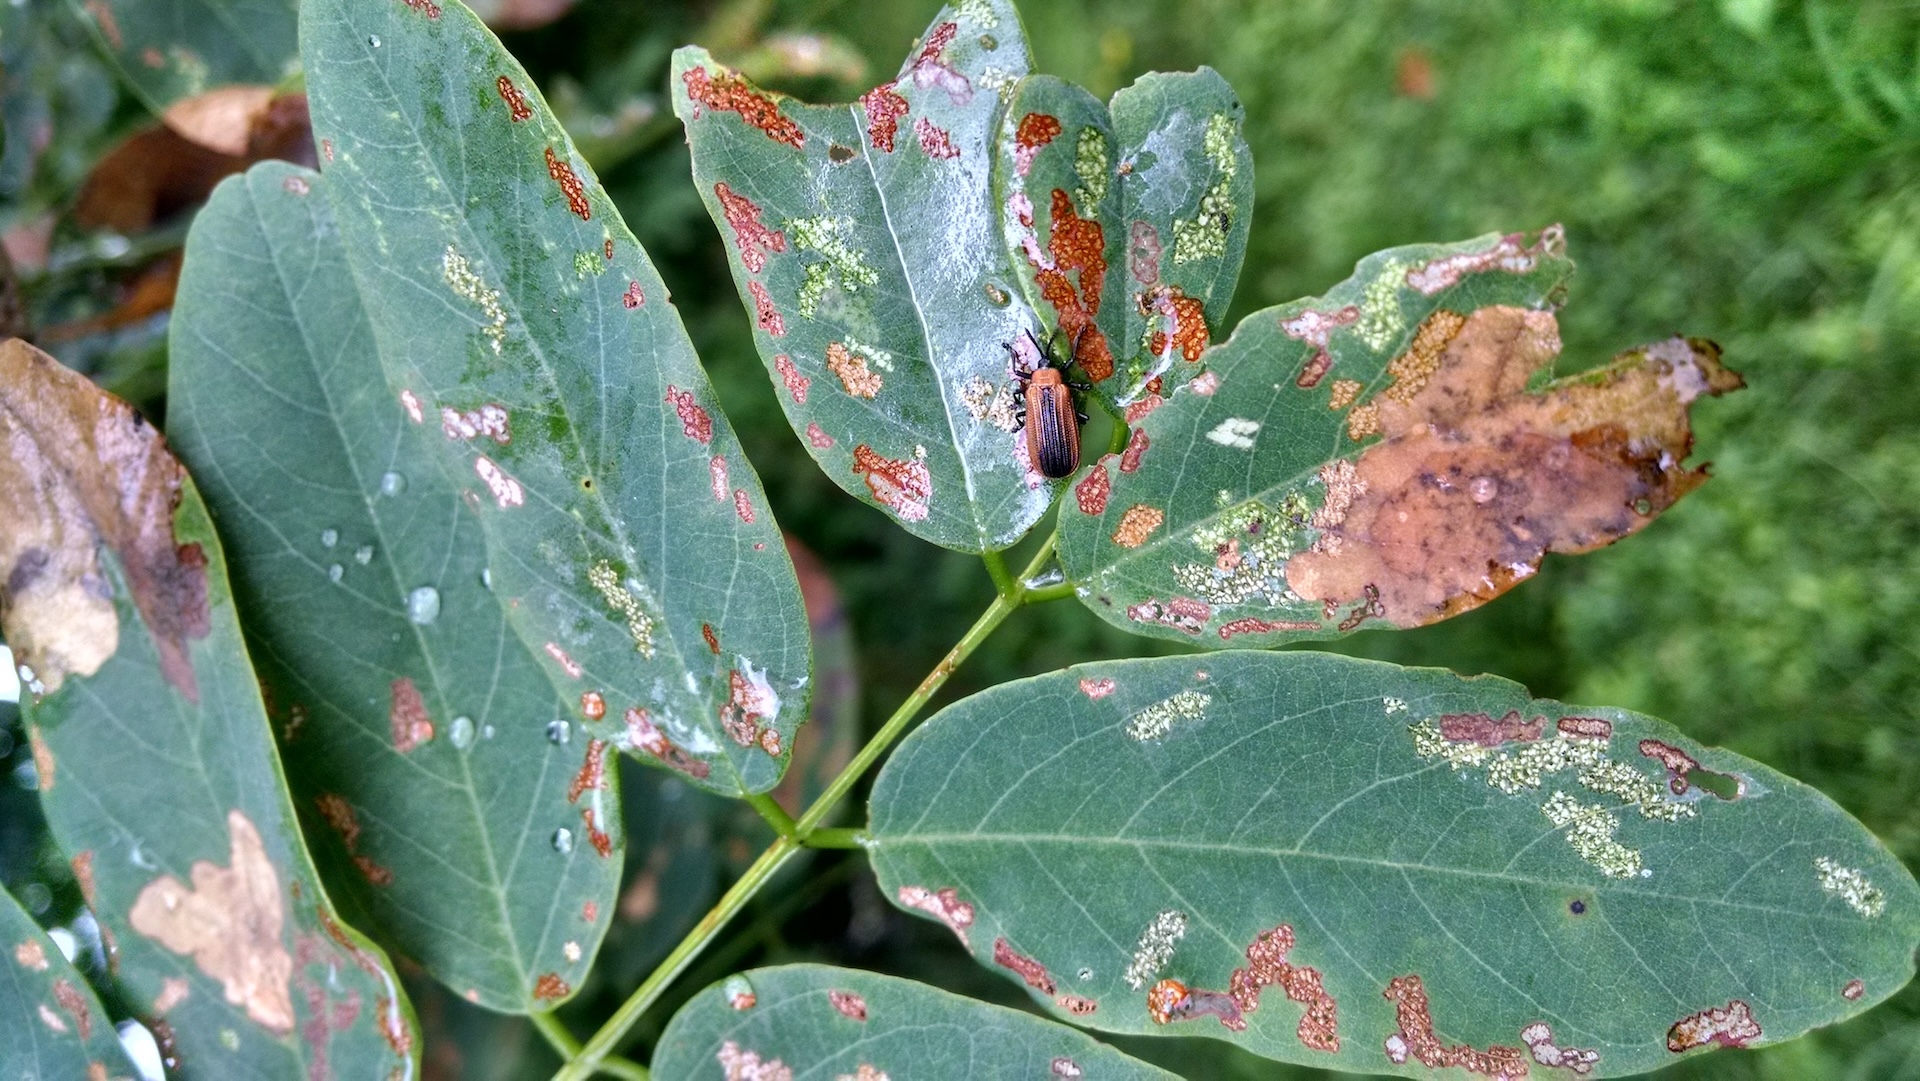
El clima puede cambiar el mapa de plagas en bosques de Norteamérica
Un estudio proyecta que, si las emisiones siguen altas, más del 80% de los bosques analizados en Norteamérica podría enfrentar mayor presión de plagas y enfermedades hacia mediados de siglo.
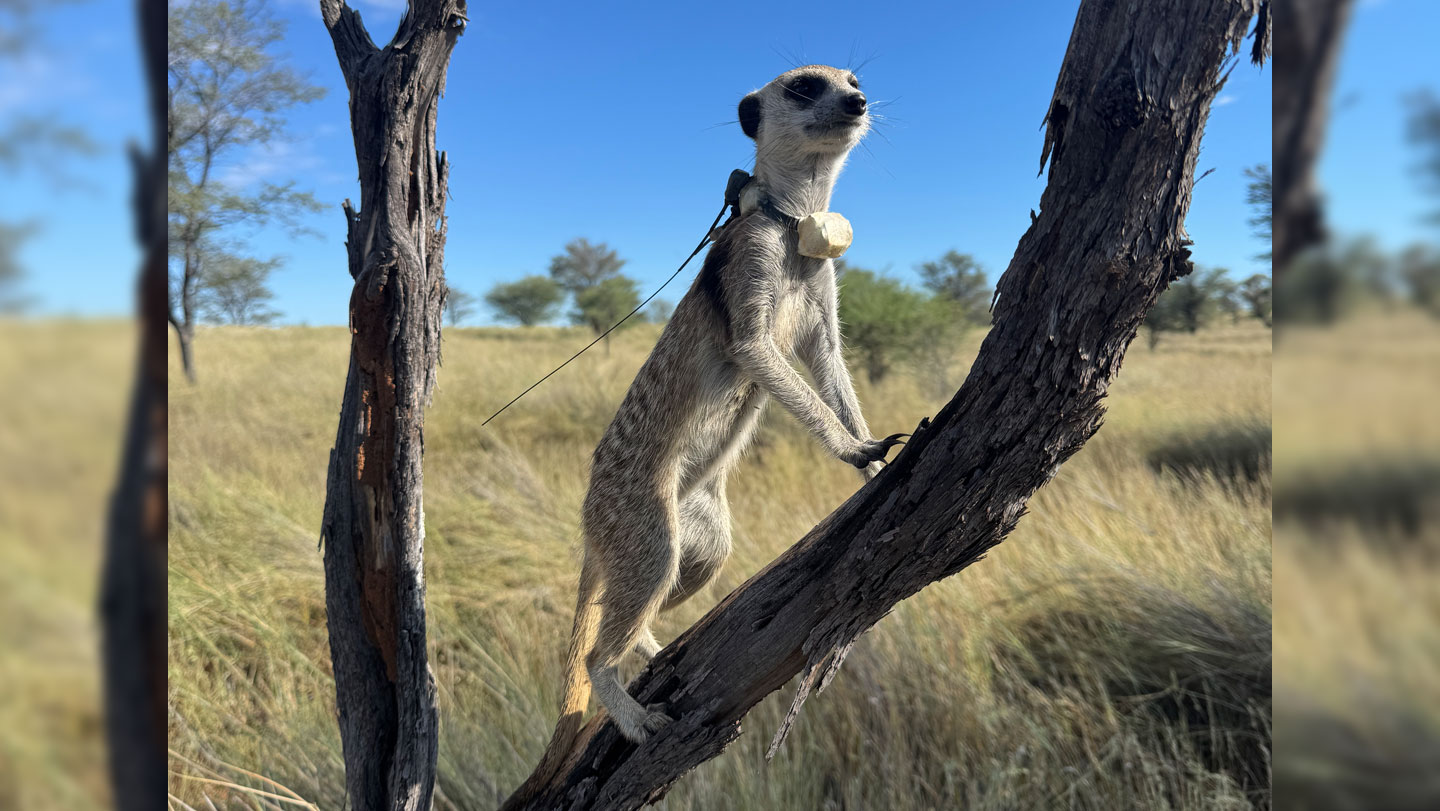
Las suricatas pueden volver solas a su grupo tras ser desplazadas
Un experimento de campo halló que 18 de 20 suricatas desplazadas a 1,5 kilómetros regresaron de forma dirigida, sin seguir a otros miembros de su grupo.
Un material seco podría extender el uso de ecografías portátiles sin gel
Una interfaz elástica y seca transmitió ultrasonido durante días en pruebas de laboratorio y siguió el flujo sanguíneo durante un paseo en bicicleta.